2026年9月30日更新
未来創造基盤AI - 企業におけるAI活用戦略
「大量の知識 = 知能」という持論の通り、近年のAIは学習したデータから回答する「内挿(補間)」にとどまらず、未学習の領域に対しても推論を展開する「外挿」の能力を高めています。主要なAI開発企業は、この特性を活かしてAIが自身で学習・改善を繰り返す再帰的な進化を加速させており、シンギュラリティ(Singularity: 技術的特異点)への到達も現実味を帯びてきました。
現在、Web上で公開されている論文や各種マニュアルの多くは LLM(大規模言語モデル)や VLM(視覚言語モデル)に学習され、「AIによる情報検索」はすでに日常的なものとなっています。しかしその一方で、多くの企業が長年の歴史の中で蓄積してきた「非公開の独自技術・実験データ・知見」はAIに学習されることなく、現在も人手で検索・探索されているのが実状ではないでしょうか?
このような外部環境の変化の下、企業におけるAI活用は、「社内FAQやAI検索」などによる「知識の探索」だけで満足してよいはずがありません。
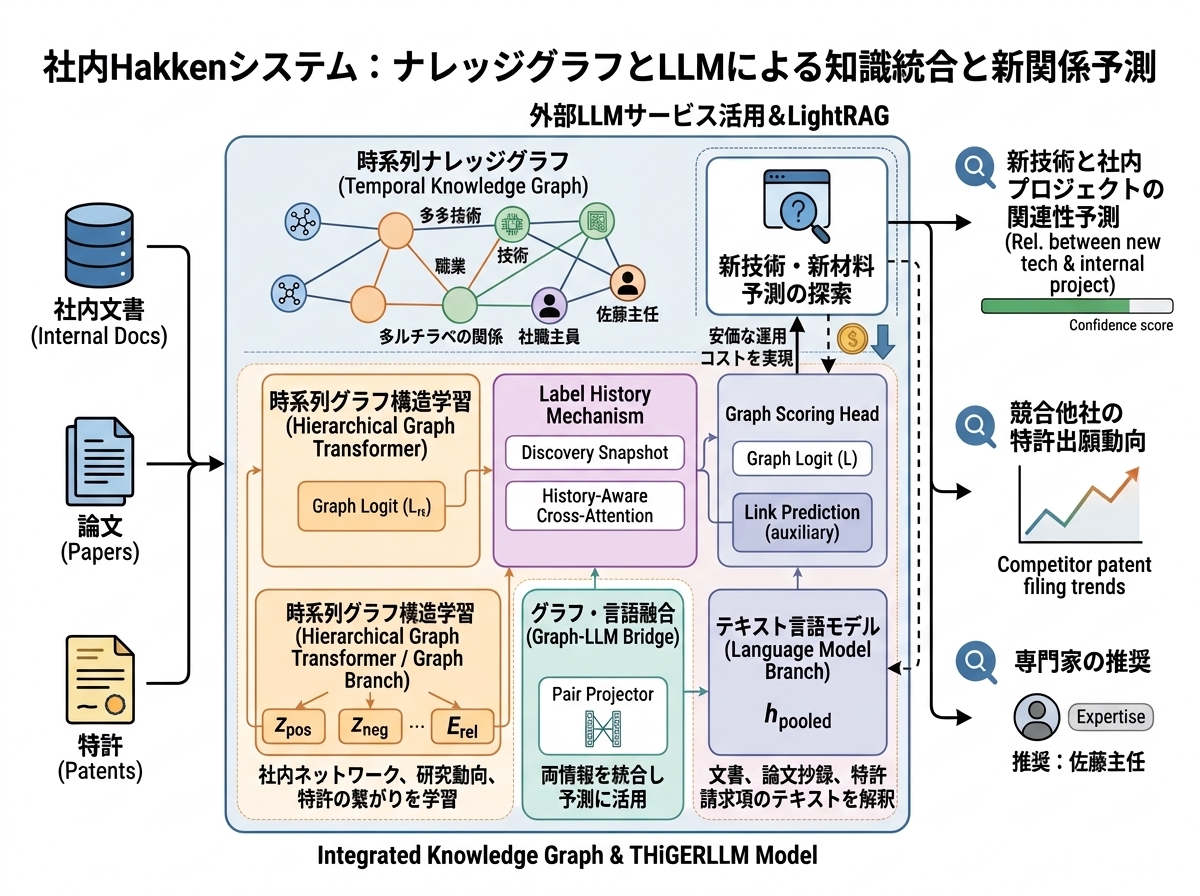
既存の知識を単に調べるだけでなく、知識と知識の「隙間」を埋めて新たな発見や仮説を予測する...。本ページでは、研究論文 Hakken: Predicting future discoveries to fill the gaps in today's knowledge の思想と仕組みをベースに、自社の社内文書・論文・特許を統合し、まだ誰も特許を取っていない未来のR&Dテーマや新材料(ホワイトスペース)を自発的に創造する比較的安価な「社内 Hakkenシステム」の活用法について解説します。
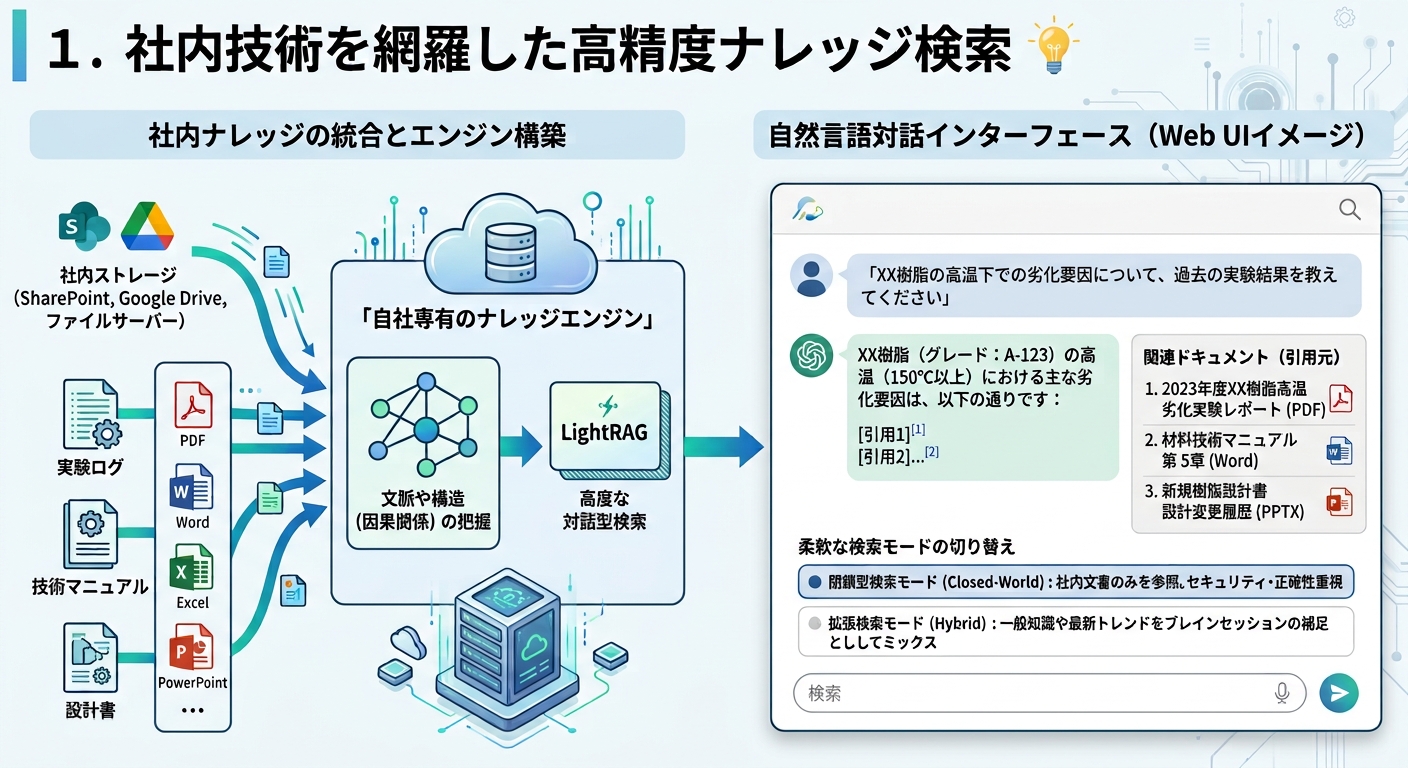
1. 社内技術を網羅した高精度ナレッジ検索
- 自社専用の自然言語対話インターフェース
- 社内に散在する実験ログ・技術マニュアル・設計書(PDF/Office文書)を統合し、「自社専有のナレッジエンジン」を構築。
- キーワード検索では届かない「文脈や構造(因果関係)」を踏まえた高度な対話型検索を実現。
- 柔軟な検索モードの切り替え(ハイブリッド運用)
- 閉鎖型検索モード(Closed-World): 社内文書のみを参照し、セキュリティと正確性を最優先。
- 拡張検索モード(Hybrid): 一般知識や最新トレンドを適宜ブレインセッションの補足としてミックス。
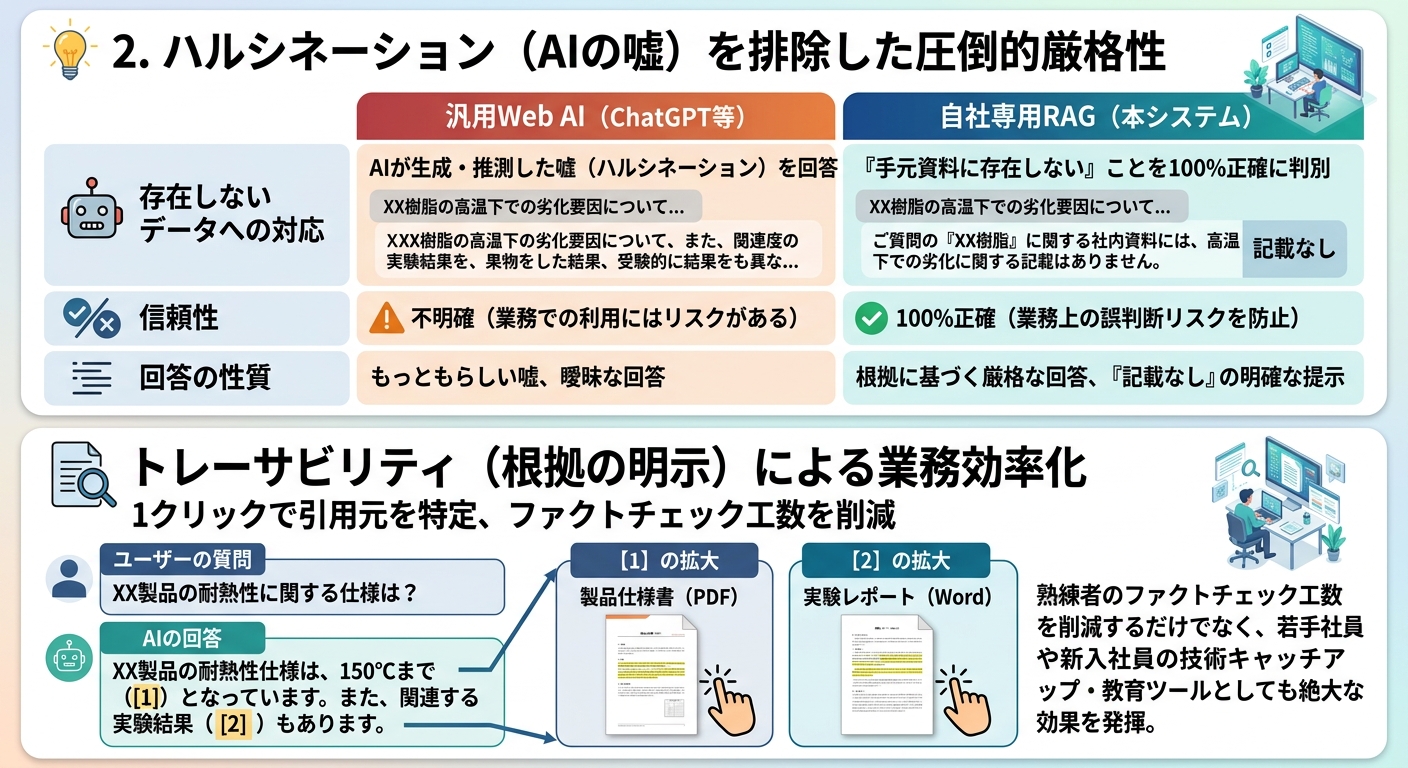
2. ハルシネーション(AIの嘘)を排除した圧倒的厳格性
- 「手元データに存在しない」ことを 100% 正確に判別
- 一般のWeb AI(ChatGPT等)で懸念される「知ったかぶり(ハルシネーション)」を完全に遮断。
- 資料内に記載がない場合は「記載なし」と明確に回答し、業務上の誤判断リスクを防止。
- トレーサビリティ(根拠の明示)による業務効率化
- 回答のすべての要素に「元となる社内ドキュメントの該当箇所(引用元)」を1クリックで特定可能な形で紐付け。
- 熟練者のファクトチェック工数を削減するだけでなく、若手社員や新入社員の技術キャッチアップ・教育ツールとしても絶大な効果を発揮。
3. RAG手法の比較:ベクトルDB vs ナレッジグラフ vs 統合型(LightRAG)
- 前期「Hakkenシステム」は、ドメインに依存しない大規模なシステムですので、運用コストがとても高くなってしまいます。
- このようなシステムを比較的安価に実現するため、ベクトルDBとナレッジグラフの双方の統合型である LightRAGを使い、LLM による知識統合を行って新たな関係を予測する「社内 Hakkenシステム」を提案します。
| 比較項目 | ベクトルDB(標準RAG) | ナレッジグラフ(GraphRAG) | 双方の統合型(LightRAG等) |
|---|---|---|---|
| 得意な検索レベル | 低層(詳細・ピンポイント) 特定のフレーズや局所的な事実の抽出 |
高層(文脈・全体像) 複数文書に跨がるテーマ要約・構造把握 |
全階層(低層 + 高層) 具体的事実から全体的文脈までを一括カバー |
| 特徴が出る理由 | テキストを固定幅のチャンクに切り分け、単語の類似度(ベクトル距離)で検索するため | エンティティ(概念)とリレーション(関係)をネットワーク化して構造保持するため | 局所のベクトル検索と、グラフのトポロジー(関係性)探索を同時平行で行うため |
| ノイズに対する耐性 | 低い 意味的に近いだけの無関係な単語や類似文脈を誤って拾いやすい(ハルシネーションの原因) |
高い 「AはBである」という確定した関係性エッジに基づいて辿るためノイズに強い |
極めて高い グラフ構造でコンテキストを絞り込みつつ、詳細をベクトルで確認するため精度がブレない |
| 処理コスト・応答速度 | 低コスト・高速 シンプルな埋め込み計算とインデックス検索のみ |
高コスト・低速 グラフ構築時のLLM呼び出しと検索時の多段階探索で計算負荷が大きい |
最適化(低コスト・高速) 二層検索の軽量化やキャッシュを活用し、GraphRAGより大幅に低コスト化 |
| 総合的な評価 | 単体の事実検索には優れるが、概念同士の繋がりや要約に弱い | 精度と推論力は極めて高いが、運用・計算コストがボトルネック | 精度(低層+高層)とコスト(速度)の双方を両立した最も実用的な構成 |
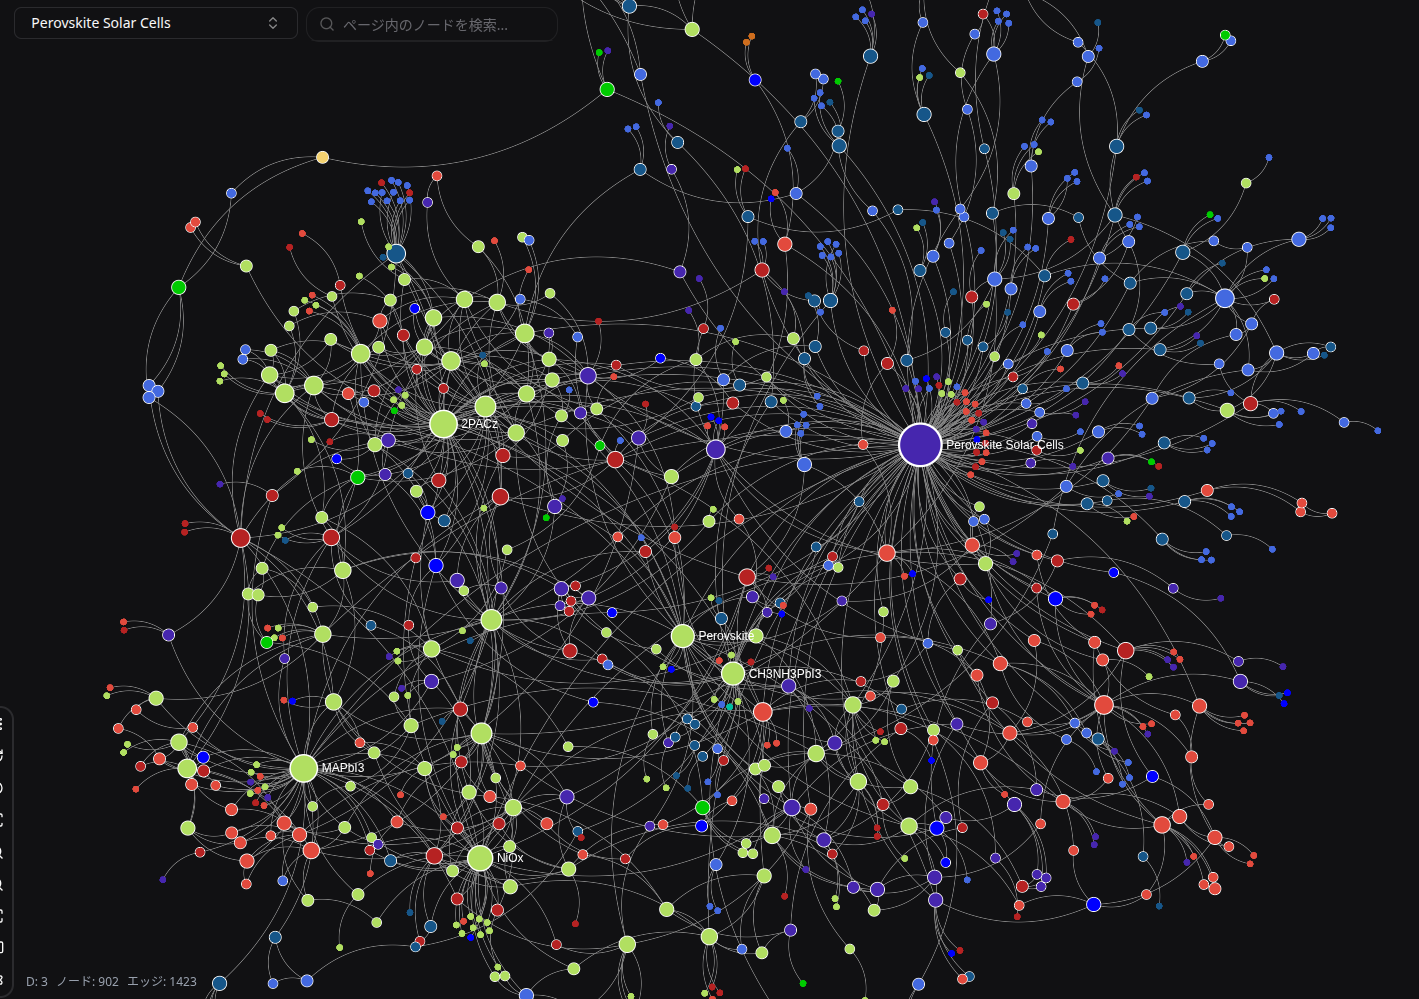
4. 社内「Hakken」システムで未来のイノベーションを創造
- 「社内文書 × 論文 × 特許」を同一ナレッジグラフ上で統合
- 社内の未解決課題や独自データに対し、Google Patentsや学術DBから取り込んだ「公知の最新論文・特許データ」をグラフィカルに自動結合。
- 「未来のR&Dテーマ」と「特許アイデア」の先回り提案
- 単なる過去データの検索ツールを超え、AIが知識の隙間(Gap)を分析して「次に検証すべき実験テーマ」を自発的に提案する相棒へと進化。
- 「ホワイトスペース(知財の空き地)」の自動炙り出し
- 「まだ誰も特許権を取得していない狙い目の技術領域や新材料」を時系列知識グラフとLLMの推論によって特定し、R&Dおよび知財戦略の競争力を劇的に向上。
【参考文献】
* 無断転載禁止。
* どのページでもご自由にリンクして下さい。
* ご意見・ご質問等がございましたら
こちらからメールをご送付下さい。
無料SEO対策
-172.31.37.45。