2026年10月18日作成
pdf2ja 学術論文の日本語翻訳
Google 翻訳 や DeepL などの一般的な自動翻訳ツールでは、学術論文に含まれる数式が崩れてしまい、きれいに表示されないことがほとんどです。しかし、
pdf2ja は数式や図表・レイアウトの位置関係を完全に保持したまま日本語に翻訳するため、数式が崩れず、元の論文と同じ品質で表示されます。
PDFMathTranslate をベースに、学術論文の日本語翻訳および組版精度を大幅に向上させた拡張リポジトリです。
比較的安価な LLM(
gemini-2.5-flash, gpt-oss-120b, deepseek-v4.1-flash 等)を用いた翻訳に対応し、特に 参考文献(References)セクションの文字切れ・改行誤爆・組版オーバーフロー問題 を根本から解決しています。
本ツールは GitHub: ShinjiKawamoto00/pdf2ja にて公開しているオープンソースプロジェクトです。ソースコード・更新情報・バグ報告はこちらからお願いします。
📊 翻訳サンプル(原文 vs gemini-2.5-flash)
下図は、検証論文 arXiv:1708.07606 の原文(英語)と、
gemini-2.5-flash による日本語翻訳結果の1ページ目を並べたものです。各画像をクリックすると、対応するPDFを開くことができます。
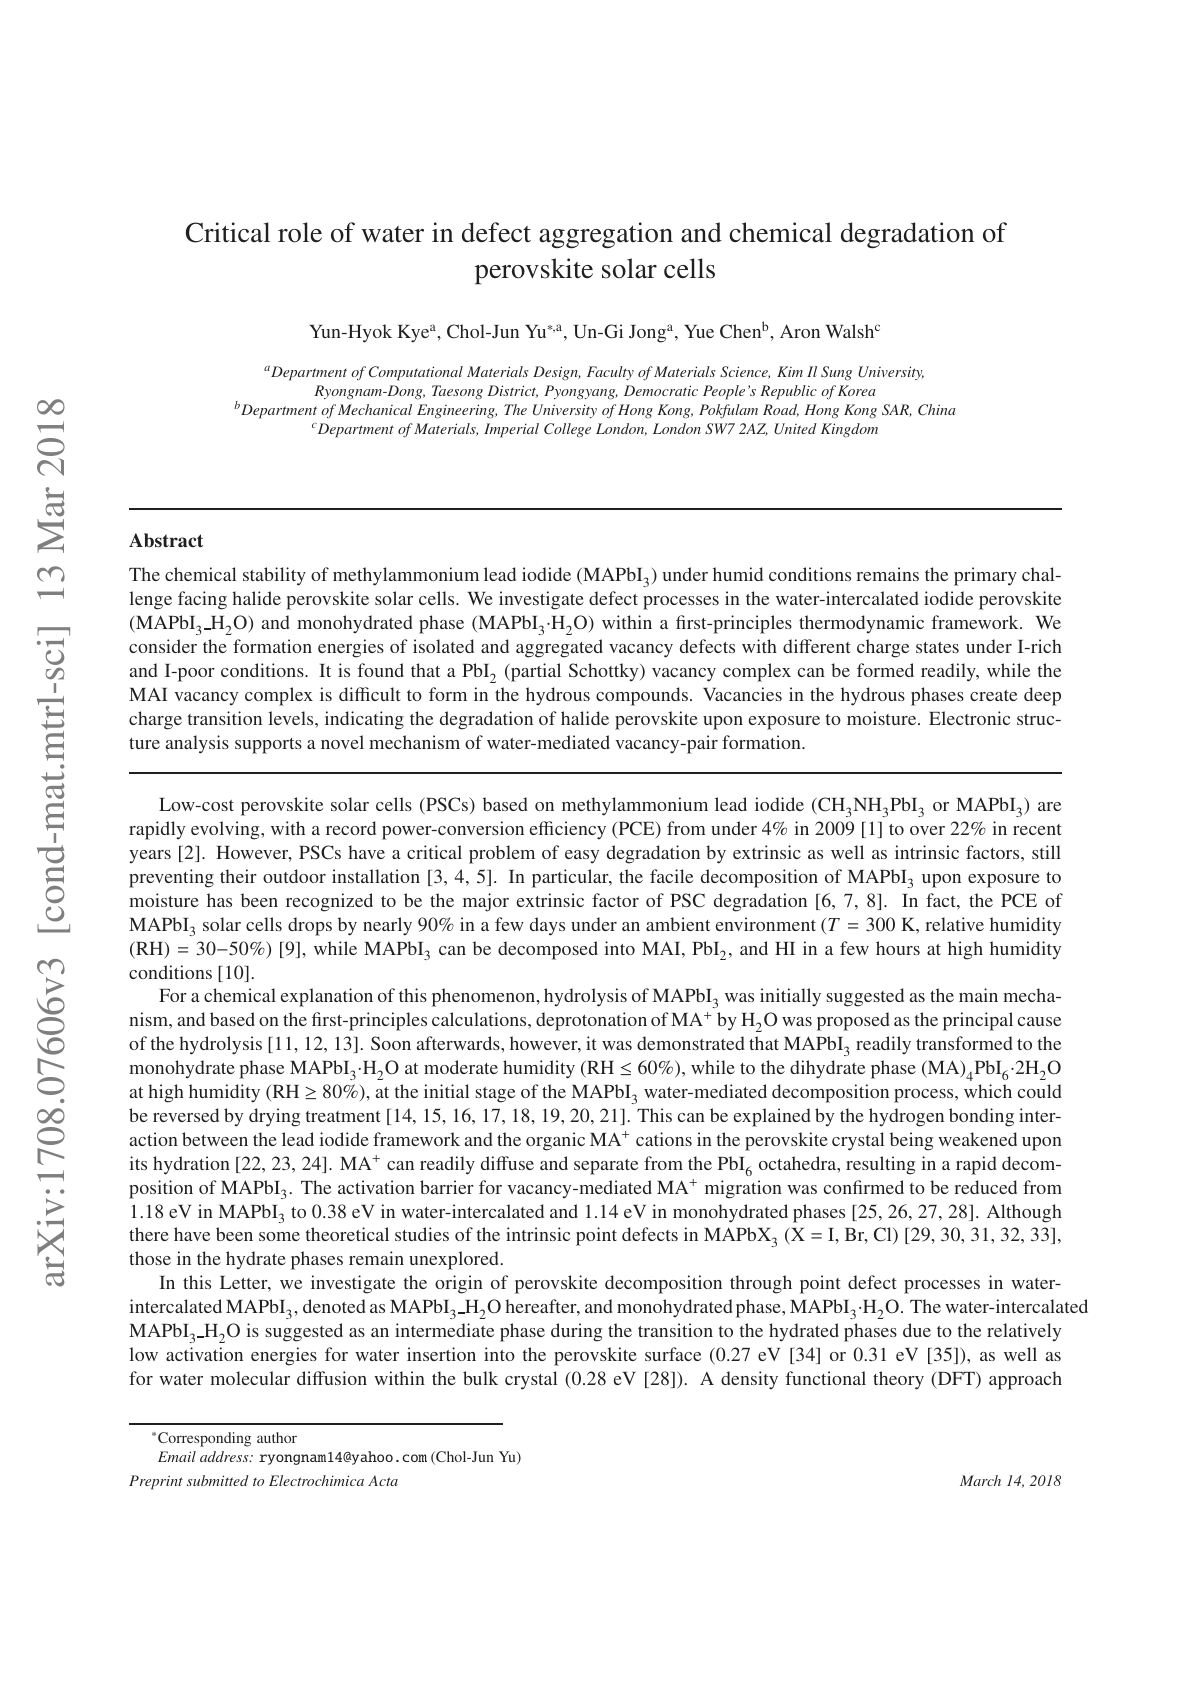
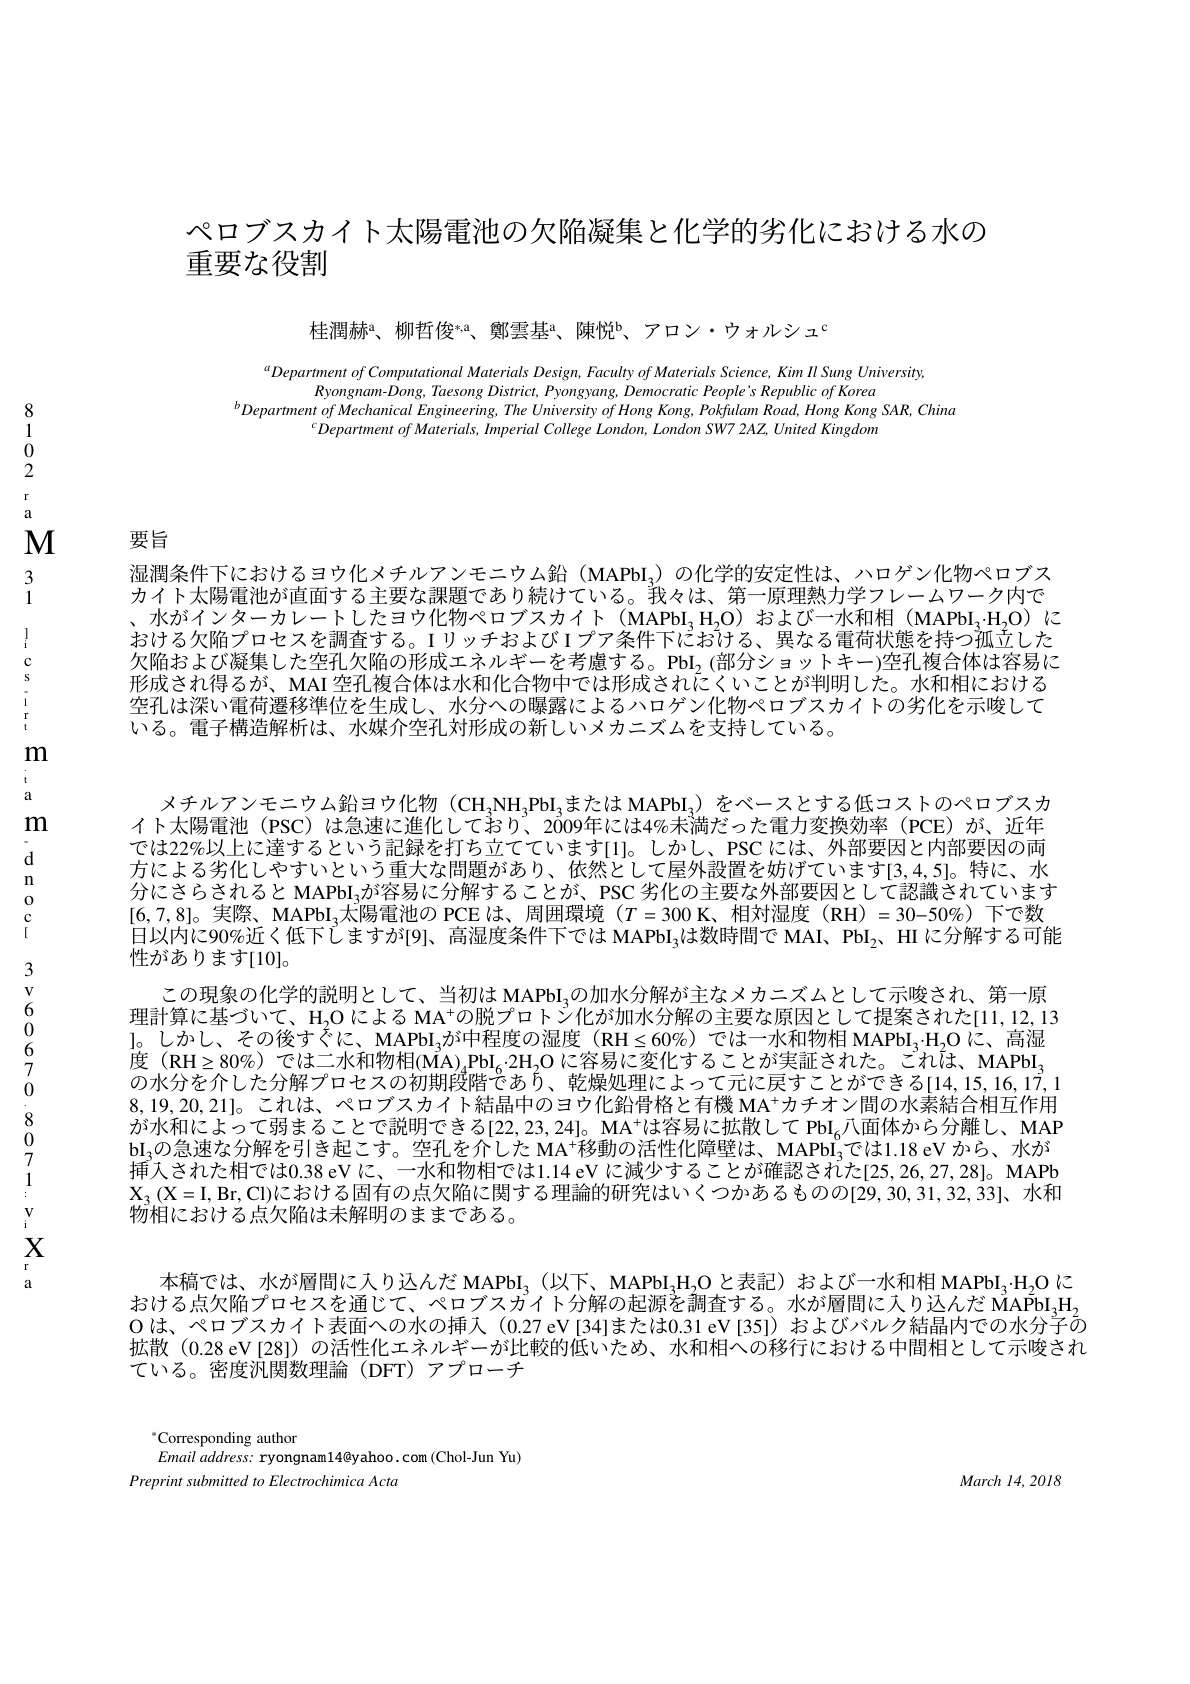
左: 原文(英語) / 右: gemini-2.5-flash による日本語翻訳(画像クリックでPDFが開きます)
✨ 主な特徴
- 学術論文レイアウトの完全保持: 数式や図表の位置関係を維持したまま日本語翻訳・レイアウト再構成。
- 参考文献セクションの高度な自動整形:
- 文献番号(
[1],1.等)での正確な改行挿入。 - 本文中の引用記号(例:
0.27 eV [34])や発行年(例:(2009))での誤改行(誤爆)を判定・自動防止。
- 文献番号(
- 長大ブロックの自動分割翻訳(チャンク処理): 多数の参考文献が含まれるブロックを自動検知して分割送信し、LLM の出力トークン制限(
max_tokens)による途切れを防止。 - 組版エンジンの物理改行対応: 改行コード(
\n)を適切にハンドリングし、自然な行送り・カーソル復帰を実現。 - 動的フォント・行間リサイズ(オートスケール): 改行増加による高さ溢れが発生した場合、行間およびフォントサイズを自動調整してページ枠内にピッタリ収容。
- クリーンな CLI コンソール出力: デバッグログを抑制し、プログレスバーをベースとした見やすい進捗表示を実現。
🛠️ 従来の課題と本リポジトリでの改善点
| 課題 | 従来の挙動 | pdf2ja での解決策 |
|---|---|---|
| 参考文献の結合 | 文献番号の前で改行されず、前後が1行に結合する | 正規表現により [1] や 1. の直前に確実に改行を挿入 |
| LLM の出力途切れ | 1回の送信が長大になり max_tokens 超過で途中で切れる | 参考文献が 4 件以上の場合は 5 件単位に自動分割して翻訳・結合 |
| 年号での誤改行 | (2009) などのカッコ数字で不自然に改行される | パターンを厳格化し、本文引用と参考文献リストを判別(is_reference_section) |
| 組版の改行無視 | \n がスペース扱いされ、右端まで改行されない | 組版エンジン(converter.py)で \n を検知して行送り処理を実行 |
| 枠外オーバーフロー | 行数増加によりページ下部で文献が枠外に消える | 行間を最大 0.75 まで圧縮し、必要に応じてフォントサイズを自動比例縮小 |
💡 処理フロー(技術詳細)
[ PDF入力 ]
    │
    ▼
[ 1. 参考文献判定 & 誤改行防止 (high_level.py) ]
    ├─ 本文中の引用 [34] と References の [1] を判別
    └─ 年号 (2009) などの誤誤爆を防ぎつつ番号直前に \n を挿入
    │
    ▼
[ 2. 自動チャンク分割翻訳 ]
    ├─ 参考文献数 >= 4 件の長大ブロックを検出
    └─ 5件単位で LLM へ送信し、応答を結合(トークン溢れ防止)
    │
    ▼
[ 3. 物理改行 & オートスケール組版 (converter.py) ]
    ├─ \n を検知してカーソルを左端復帰・次行へ移動
    └─ 段落高さ枠を超える場合、行間・フォントサイズを自動縮小
    │
    ▼
[ 高品質な日本語PDF出力 ]
📦 インストール
pdf2ja は Python 3.11 〜 3.13.7 で動作します。ここでは pyenv を用いた仮想環境構築を例に示します(venv / conda でも同様です)。
前提条件(共通)
# 1. pyenv で Python 3.13.7 をインストール
pyenv install 3.13.7

# 2. 専用仮想環境を作成してアクティベート
pyenv virtualenv 3.13.7 Pdf2ja3.13.7
pyenv activate Pdf2ja3.13.7

# 3. pip を最新化
pip install --upgrade pip

# 4. リポジトリをクローンし、そこに移動
git clone https://github.com/ShinjiKawamoto00/pdf2ja.git
cd pdf2ja
5.1 GPU (CUDA) 版のインストール(高速レイアウト解析・推奨)
NVIDIA GPU(CUDA 環境)を利用して、ONNX Runtime の推論を GPU アクセラレーションで実行する場合:
# GPU (CUDA) オプション付きでインストール
pip install -e ".[cuda]"
GitHub から直接インストールする場合:
pip install "git+https://github.com/ShinjiKawamoto00/pdf2ja.git#egg=pdf2ja[cuda]"
5.2 CPU 版のインストール(GPU なし・標準環境)
GPU を搭載していないマシン、または CPU のみで軽量に動作させる場合:
# 標準(CPU版)インストール
pip install -e ".[cpu]"
GitHub から直接インストールする場合:
pip install git+https://github.com/ShinjiKawamoto00/pdf2ja.git
動作確認(ONNX Runtime のプロバイダ確認)
インストール後、ONNX Runtime がどの実行プロバイダで動作しているか確認します。
python -c "import onnxruntime as ort; print(ort.get_available_providers())"
| 環境 | 期待されるプロバイダ例 |
|---|---|
| CPU 版 | ['CPUExecutionProvider'] |
| GPU (CUDA) 版 | ['CUDAExecutionProvider', 'CPUExecutionProvider'] など |
CUDAExecutionProvider が含まれていれば GPU アクセラレーションが有効です。
🚀 使い方
1. 環境変数の設定(.bashrc / .bash_env)
翻訳サービスの API キーとベースURLだけ設定します。モデルは
--service オプションで指定するので、ここでは不要です。
OpenRouter の場合(無料枠あり、OpenAI 互換 API):
export OPENAI_BASE_URL='https://openrouter.ai/api/v1'
export OPENAI_API_KEY='sk-or-あなたのOpenRouter APIキー'
Groq の場合(無料枠あり、高速):
export OPENAI_BASE_URL='https://api.groq.com/openai/v1'
export OPENAI_API_KEY='あなたのGroq APIキー'
設定を反映:
source ~/.bashrc
# または
source ~/.bash_env
2. --service の指定形式
--service(-s)は サービス名:モデル名 の形式で指定します。
pdf2ja input.pdf --service openai:google/gemini-2.5-flash --output output_ja.pdf
3. CLI コマンドの基本的なオプション設定例
# 基本的な翻訳実行(英語→日本語)
# --output を指定しない場合は `入力ファイル名`-mono.pdf が作成されます
pdf2ja input.pdf --output output_ja.pdf

# ページ範囲を指定して実行(1ページずつテストする際に便利)
pdf2ja input.pdf --pages 1 --output output_ja.pdf
pdf2ja input.pdf --pages 1-5 --output output_ja.pdf

# デバッグ情報を表示して実行
pdf2ja input.pdf --output output_ja.pdf --debug

# 出力ディレクトリを指定
pdf2ja input.pdf --output ./translated

# キャッシュを無視して強制的に再実行
pdf2ja input.pdf --output output_ja.pdf --ignore-cache

# GPU の cuDNN エラーを回避する場合は CPU モードで実行
pdf2ja input.pdf --service openai:google/gemini-2.5-flash --backend cpu --output output_ja.pdf
🧪 様々なモデルを使用した検証結果
論文 Critical role of water in defect aggregation and chemical degradation of perovskite solar cells を使用して和訳の検証を実施。
1. Groq
1.1 gpt-oss-120b
- 比較的高速に処理されます。
pdf2ja 1708.07606.pdf --service openai:openai/gpt-oss-120b
📄 翻訳サンプル: 1708.07606-mono_groq_gpt-oss-120b.pdf
2. OpenRouter
2.1 gpt-oss-120b
- デフォルト Balanced (price + speed) だとやや遅く感じる
- バランスを重視してチャンクごとに様々なプロバイダーが選択される
pdf2ja 1708.07606.pdf --service openai:openai/gpt-oss-120b
速度を重視する場合は
:nitro を付加すると Cerebras のみが選択され、Groq と遜色ないスピード感で翻訳される(2026.10.17 現在)。なお、OpenRouter には Groq も含まれている、末尾に :groq を付加すれば選択可能。
pdf2ja 1708.07606.pdf --service openai:openai/gpt-oss-120b:nitro
2.2 gemini-2.5-flash
- 比較的安定したモデル。
pdf2ja 1708.07606.pdf --service openai:google/gemini-2.5-flash
2.3 claude-haiku-3.5
- 警告(RateLimitError)が出ることがあるが、翻訳自体は成功する
--thread 1を指定すると並列処理(同時APIリクエスト)が1(逐次処理)に制限され、APIのレート制限をほぼ確実に回避できる
pdf2ja 1708.07606.pdf --service openai:anthropic/claude-haiku-3.5 --thread 1
2.4 OpenRouter の deepseek-v4.1-flash
中国企業が開発したモデルですが、欧米のサーバー限定で稼働させると安心。米国でもトップの人気を誇るモデル(2026年10月)。高機能でありながら低価格が魅力。
pdf2ja 1708.07606.pdf --service openai:deepseek/deepseek-v4.1-flash
2.5 nemotron-3.5-lightning:free・nemotron-3-ultra-550b-a55b:free
- 無料バージョンだとほとんど成功しない
pdf2ja 1708.07606.pdf --service openai:nvidia/nemotron-3.5-lightning:free
pdf2ja 1708.07606.pdf --service openai:nvidia/nemotron-3-ultra-550b-a55b:free
2.6 gpt-oss-20b
- 小さなモデルでは pdf2ja 内部でのパース待ち・ハングアップして成功しない
pdf2ja 1708.07606.pdf --service openai:openai/gpt-oss-20b
📜 ライセンス
本プロジェクトは PDFMathTranslate をベースに開発されています。
* 無断転載禁止。
* どのページでもご自由にリンクして下さい。
* ご意見・ご質問等がございましたら
こちらからメールをご送付下さい。
無料SEO対策
-172.31.37.45。